
阶跃星辰Step 5 Preview震撼发布,开源模型格局要变?


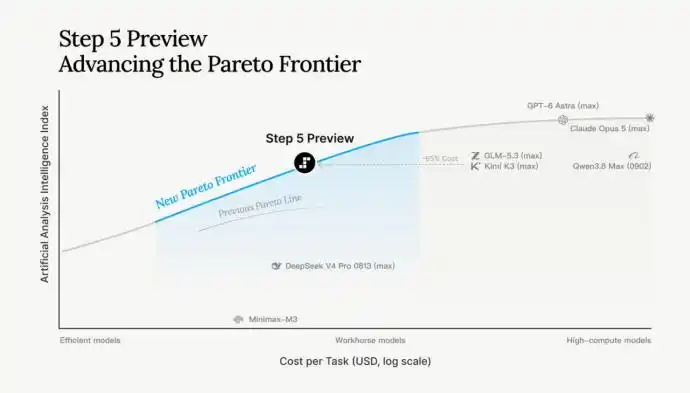
阶跃星辰于2026年9月20日正式发布新一代旗舰基座模型Step 5 Preview,采用600B总参数稀疏MoE架构,激活参数仅27B,支持100万Token上下文,AA智能指数得分44分跻身全球开源前三,单任务成本仅为Claude Opus 5的1/8,10月15日将开源完整权重。
一、Step 5 Preview模型到底发布了什么?
1.1 产品定位与发布节奏
2026年9月20日,阶跃星辰(StepFun)发布新一代旗舰基座模型Step 5 Preview。这款Step 5 Preview模型被官方定位为“面向真实世界Agentic任务的主力工作模型”,重点覆盖AI编程、软件工程、专业知识工作、金融分析等需要长上下文、持续规划和工具调用的复杂场景。
值得注意的是发布节奏的安排。Step 5 Preview模型在发布当日即全量开放API,而完整模型权重则定于10月15日正式开源。这种“先开放使用、后开源权重”的策略,在国产大模型阵营中并不常见。它意味着开发者可以在模型权重开放之前先进行充分的API测试和应用验证,降低了技术选型的不确定性。
阶跃星辰选择跳过Step 4.x的编号直接进入Step 5,这一动作传递的信号很明确:Step 5 Preview模型不是一次常规迭代,而是阶跃星辰在技术路线上的一次重要跃迁。
1.2 与前代模型的关系
回顾阶跃星辰的产品脉络,从Step 3.5 Flash到Step 3.7 Flash,再到今天的Step 5 Preview模型,一条清晰的技术演进主线浮出水面——提升“计算转化为智能的效率”。Step 3.5 Flash以196B总参数、11B激活参数在实时Agent工作流场景中建立了基础;Step 3.7 Flash进一步面向生产级Agent打造,上线一个月即登顶OpenRouter平台OpenClaw调用量月榜全球第一。
Step 5 Preview模型则将这一路线推向了新的高度:参数规模从前代的196B跃升至600B,激活参数从11B提升至27B,上下文窗口扩展至100万Token,并新增了原生视觉输入能力。这不是简单的规模堆叠,而是一次系统性的架构升级。
二、核心技术架构解析
2.1 稀疏MoE架构:参数效率的极致追求
Step 5 Preview模型最引人注目的技术特征,是其稀疏混合专家(MoE)架构。总参数量600B,但每个Token仅激活约27B参数——这意味着每次推理只调用约4.5%的参数。
这个比例值得细细品味。传统的密集模型在推理时需要激活全部参数,而Step 5 Preview模型通过MoE的门控机制,让不同的输入Token被路由到不同的“专家”子网络中。这种做法在保持旗舰级智能水平的同时,将推理成本压低到了同等智能水平模型中罕见的低位。
用一组数据来感受这种效率:Step 5 Preview模型的输入定价为每百万Token 1美元,输出定价为每百万Token 2.7美元。而同期行业中位数分别为输入1.88美元、输出10美元。输入成本低了约47%,输出成本低了约73%。换句话说,Step 5 Preview模型在同等智能水平下,让使用者的每一分算力预算都能覆盖更多的实际任务量。
2.2 “窄而深”的92层设计
在模型深度与宽度的取舍上,Step 5 Preview模型选择了一条不同的路径。当业界主流趋势倾向于通过增加网络宽度来提升模型容量时,Step 5 Preview模型采用了“窄而深”的设计思路——总共包含92层Transformer。
为什么选择更深而非更宽?这与Step 5 Preview模型的核心应用场景密切相关。在真实的Agent任务中,模型需要连续进行搜索、执行代码、调用外部工具,工具返回的信息会形成很长的Prefill阶段(即模型正式生成内容前处理输入上下文的阶段)。阶跃星辰的研发团队认为,增加模型深度可以为长Prefill中的隐式多跳推理提供更长的信息传播路径,让Step 5 Preview模型在处理复杂链式任务时表现得更加稳健。
2.3 百万上下文的关键技术突破
100万Token的上下文窗口是Step 5 Preview模型的核心能力之一。大约相当于1500页A4纸的文本量,足以容纳一个中型软件项目的完整代码库,或者一份深度研究报告的全部参考文献。
但长上下文的真正挑战不在于“能装多少”,而在于“能用多好”。Step 5 Preview模型引入了Sparse GQA机制,通过稀疏索引只选择与当前任务相关的历史信息进入注意力计算。在此基础上,Block-wise Token Merging技术将相邻的、Top-k结果高度重叠的Token进行合并,将索引和选择环节的成本降低至原来的八分之一。
这两项技术的组合,让Step 5 Preview模型在处理百万级上下文时,不会出现“信息越多、效果越差”的退化现象。这对于需要长时间跟踪任务状态的Agent场景来说,是一个关键的能力保障。
2.4 训练与推理的bit-wise对齐
长程Agent训练中有一个容易被忽视的难题:训练与推理的一致性。MoE模型会动态选择不同的专家网络,细微的数值差异可能导致路由结果发生偏移,而这种偏移会在92层网络中不断累积,最终导致训练时表现良好的策略在实际推理中失效。
Step 5 Preview模型在严格在线策略训练中实现了训练与推理的bit-wise对齐——使用确定性算子统一两侧的实现,并通过树状归约消除张量并行度对计算结果的影响。阶跃星辰披露,这套方案增加的端到端开销低于10%;在异步训练中,训练与推理的logprob偏差被控制在1e-2以内。
结合负载感知调度、MTP-3投机解码、FP8 MoE量化感知训练等一系列工程优化,Step 5 Preview模型的长程强化学习端到端加速超过三倍,训练链路中的样本丢失率控制在1%以下。这些“看不见”的工程能力,恰恰是Step 5 Preview模型能够在真实Agent任务中稳定发挥的基础。
2.5 模型参与自身迭代的数据闭环
Step 5 Preview模型的研发过程中有一个值得关注的细节:模型本身被用于构建后续迭代所需的训练数据。在这个“自进化”体系中,专家负责制定原则和关键判断,确定性操作被封装为工具,而Step 5 Preview模型则承担任务编排、跨步骤决策和部分数据生成的工作。
研发团队很快发现了一个问题:直接让Agent生成任务容易导致任务趋同,能力更强的模型甚至可能寻找评测漏洞,表面上完成了任务但没有解决真实问题。为此,阶跃星辰建立了统一上下文层和结构化知识空间,通过显式信号控制任务难度与多样性,并将反作弊审计嵌入数据流程。这套体系已经构建出百万级可验证的高难度任务,覆盖科学推理、软件工程、机器学习研发和专业工作等领域。
在真实任务中持续优化并产出可验证数据的能力,正在成为衡量基座模型实用价值的重要维度。Step 5 Preview模型在这方面的探索,为行业提供了一个有价值的参考样本。
三、性能基准:全球开源前三的含金量
3.1 AA智能指数44分意味着什么
Artificial Analysis Intelligence Index是目前全球公认的大模型综合能力评估体系之一,其v4.3版本纳入了十项独立评估,包括AA-Briefcase、GDPval-AA v2、AutomationBench-AA、Terminal-Bench 4.0、SciCode、Humanity‘s Last Exam等。
Step 5 Preview模型在这套评估体系中获得44分,位居全球开源模型前三。这个分数的含金量需要放在参照系中理解:Step 5 Preview模型与参数量高达2.8万亿的Kimi K3持平,仅落后GLM-5.3与Claude Opus 5各一分。
参数效率的差距才是真正的看点。Step 5 Preview模型以600B总参数、27B激活参数的规模,达到了与参数量约为其五倍的模型相当的智能水平。这不是靠简单放大规模实现的,而是架构设计、训练策略和工程优化共同作用的结果。
3.2 软件工程与编程能力实测
在真实软件工程评测DeepSWE v1.1中,Step 5 Preview模型(High模式)取得67.7分,超越GLM-5.3的66.9分和Kimi K3的67.5分,落后Claude Opus 5的74.0分和GPT-6 Astra的74.1分。
在StepCodeBench(阶跃星辰自建代码评测集,覆盖553个独立代码仓库、9类任务、20个应用领域和33种编程语言)中,Step 5 Preview模型取得49.0分,大幅领先GLM-5.3的40.2分和Kimi K3的43.9分。
ProgramBench的成绩同样值得关注。Step 5 Preview模型以80.5分超越了Kimi K3的77.8分和GLM-5.3的72.0分,与GPT-6 Astra的85.4分和Claude Opus 5的82.3分处于同一梯队。
3.3 专业工作与金融领域的深度表现
如果说编程能力是Step 5 Preview模型的基本盘,那么在金融和专业工作领域的表现则是它的差异化优势。
在金融投资研究评测FrontierFinance中,Step 5 Preview模型取得66.4分,领先GLM-5.3的64.1分和Kimi K3的62.6分,仅次于Claude Opus 5的69.7分,并且大幅领先GPT-6 Astra的55.0分。
在跨领域深度研究评测DRACO中,Step 5 Preview模型获得83.3分,超越GLM-5.3的82.3分和Kimi K3的78.5分,同样仅次于Claude Opus 5的87.6分。
在Agents’ Last Exam的CLI子集(ALE-CLI)中,Step 5 Preview模型取得29.5分,超越GLM-5.3的28.6分和Kimi K3的27.6分,仅次于GPT-6 Astra的33.3分。
这些成绩的分布呈现出一种清晰的格局:Step 5 Preview模型在绝大多数专业领域基准上位列开源模型第一梯队,与国际顶尖闭源模型的差距正在快速缩小,且部分指标已经实现了反超。
3.4 长周期任务的实战表现
基准测试的分数是静态的,而真实Agent任务往往是动态的、长时间的。Step 5 Preview模型在这方面展现了令人印象深刻的能力。
在24小时GPU Kernel优化任务中,Step 5 Preview模型自主持续优化H100 GPU内核,将MLA内核峰值性能提升至508 TFLOPS,超越了Claude Opus 5的493 TFLOPS。
在自动化后训练实验中,Step 5 Preview模型自主设计训练数据,将Qwen3-30B-A3B在AIME24上的准确率从53.3%提升至60%,与Claude Opus 5持平,同时消耗更少的标注Token。
更具象的案例来自硬件编程场景:Step 5 Preview模型根据自然语言需求,自主阅读ESP32设备及相关API的大量开发文档,将一块ESP32-S3开发板改造成支持蓝牙按键与语音输入的Vibe Coding键盘。它不仅能够编写代码,还能访问串口、获取截图、调用摄像头、模拟鼠标操作,并根据真实设备返回的状态和报错持续修改、运行和调试代码,连续执行超过3小时。
这些实战案例说明,Step 5 Preview模型的能力边界已经从“写代码”延伸到了“操作真实世界中的硬件和系统”。这种端到端的任务执行能力,才是Agentic模型与普通对话模型之间的本质区别。
四、横向对比:Step 5 Preview与主流模型谁更强?
| 评测维度 | Step 5 Preview (High) | Claude Opus 5 (Max) | GPT-6 Astra (Max) | GLM-5.3 (Max) | Kimi K3 (Max) |
|---|---|---|---|---|---|
| AA智能指数 | 44 | 45 | — | 45 | 44 |
| DeepSWE v1.1 | 67.7 | 74.0 | 74.1 | 66.9 | 67.5 |
| StepCodeBench | 49.0 | 63.9 | 61.0 | 40.2 | 43.9 |
| ProgramBench | 80.5 | 82.3 | 85.4 | 72.0 | 77.8 |
| ALE-CLI | 29.5 | 28.6 | 33.3 | 28.6 | 27.6 |
| FrontierFinance | 66.4 | 69.7 | 55.0 | 64.1 | 62.6 |
| DRACO | 83.3 | 87.6 | 76.8 | 82.3 | 78.5 |
| 总参数量 | 600B | 未公开 | 未公开 | 未公开 | ~2.8T |
| 激活参数 | 27B | 未公开 | 未公开 | 未公开 | 未公开 |
| 上下文窗口 | 1M | 未公开 | 未公开 | 未公开 | 未公开 |
| 输入定价(每百万Token) | $1.00 | 未公开 | 未公开 | 未公开 | 未公开 |
| 输出定价(每百万Token) | $2.70 | 未公开 | 未公开 | 未公开 | 未公开 |
| 输出速度(Token/秒) | 99.8 | 55.3 | — | — | — |
| 开源状态 | 10月15日开源 | 闭源 | 闭源 | 开源 | 开源 |
数据来源:Artificial Analysis Intelligence Index、阶跃星辰官方发布信息、DeepSWE v1.1、StepCodeBench、ProgramBench、Terminal-Bench v4、ALE-CLI、FrontierFinance、DRACO评测结果。部分模型未公开具体参数与定价信息。
从表格中可以提炼出几个关键判断。
Step 5 Preview模型在ALE-CLI(命令行Agent任务)上以29.5分超越了Claude Opus 5的28.6分,在FrontierFinance和DRACO上与Claude Opus 5的差距分别只有3.3分和4.3分。考虑到参数激活规模上的巨大差距,这种性能表现值得认真对待。
在成本效率维度,Step 5 Preview模型的优势更加突出。输入定价仅为行业价格中位数的约53%,输出定价仅为行业价格中位数的约27%。而在输出速度方面,Step 5 Preview模型达到99.8 Token/秒,明显快于Claude Opus 5的55.3 Token/秒。
一个容易被忽略的指标是缓存折扣。Step 5 Preview模型支持95%的缓存折扣,这意味着在重复调用相同或相似上下文的场景中,实际使用成本可以进一步降低。对于需要频繁处理同一份文档或代码库的企业用户来说,这个优势的累积效应不可忽视。
当然,差距依然存在。在StepCodeBench和DRACO这两个考验深度代码理解和跨领域推理的评测上,Step 5 Preview模型与Claude Opus 5之间的分差仍在10分以上。这说明在最复杂的专业任务上,国际顶尖闭源模型仍然保持着一定的领先优势。但Step 5 Preview模型已经进入了一个新的竞争区间——不再是被动追赶,而是在某些维度上开始形成自己的差异化优势。
五、开源策略与生态布局
5.1 10月15日开源意味着什么
Step 5 Preview模型将于10月15日释放完整模型权重。在当前大模型开源趋于保守的环境下,一家创业公司选择将旗舰级基座模型开源,这个决定本身就值得关注。
开源完整权重的意义不仅在于降低使用门槛,更在于为学术界和产业界的研究者提供了一个可复现、可分析的技术底座。研究者可以深入研究Step 5 Preview模型的MoE路由机制、稀疏注意力实现等底层技术细节,这些在闭源模型中是无法获知的。
5.2 芯片适配与产业协同
回顾阶跃星辰此前的开源实践,Step 3.5 Flash发布时,多家头部芯片厂商已经完成了适配。这一模式很可能延续到Step 5 Preview模型上。模型与国产芯片的深度适配,对于降低推理成本、拓展应用场景具有重要意义。
5.3 从OpenRouter数据看实际使用趋势
Step 3.7 Flash上线一个月即登顶OpenRouter平台OpenClaw调用量月榜全球第一。这个数据反映了一个重要趋势:开发者社区对阶跃星辰系列模型的接受度正在快速提升。Step 5 Preview模型凭借更强的综合能力和更具竞争力的定价,有望进一步扩大这一使用基础。
六、行业格局:AI开源竞赛进入新阶段
6.1 开源阵营的“参数效率竞赛”
2026年的开源大模型竞争,已经不再是单纯的参数规模比拼。Step 5 Preview模型以600B总参数对标Kimi K3的2.8万亿参数,GLM-5.3则在保持较高智能水平的同时强调效率优化。开源阵营正在从“谁更大”转向“谁更高效”。
这种转变的背后是产业需求的驱动。企业用户在评估模型时,已经不再只看基准分数,而是将推理成本、响应速度、部署复杂度等工程指标纳入综合考量。Step 5 Preview模型在能力、成本、效率与场景覆盖之间的平衡策略,代表了这一趋势下的务实选择。
6.2 闭源与开源的能力差距还剩多少
从AA智能指数来看,Claude Opus 5得45分,GLM-5.3得45分,Step 5 Preview模型与Kimi K3各得44分。开源模型与闭源模型在综合智能评分上的差距已经缩小到了1-2分的区间。
这种差距的缩小,对于整个AI应用生态来说是一个积极信号。当开源模型的能力足够接近闭源模型时,企业用户在选择技术方案时就有了更多的自主权,可以根据数据安全要求、成本预算、部署环境等因素做出更适合自身需求的选择。
6.3 Step 5 Preview模型的差异化路径
Step 5 Preview模型最独特的地方,在于它对“Agentic任务”的深度聚焦。当大多数模型还在追求通用对话能力时,Step 5 Preview模型从架构设计阶段就将真实世界Agent任务作为核心优化目标——92层深度架构服务于长Prefill推理,Sparse GQA服务于百万上下文,bit-wise对齐服务于长程强化学习的稳定性。
这并不意味着Step 5 Preview模型放弃了通用能力。但在编程、金融、专业工作等高频Agent场景中的持续深耕,正在形成一种“场景驱动的技术优化飞轮”:更好的场景表现产生更多的用户反馈和真实任务数据,这些数据反过来又推动模型的进一步优化。
七、深度洞察:Step 5 Preview模型给行业带来了什么启示?
7.1 “智能效率”正在取代“参数规模”成为核心指标
Step 5 Preview模型最值得深思的地方,不在于它达到了什么分数,而在于它用什么代价达到了这个分数。
600B总参数、27B激活参数,意味着每生成一个Token,模型只调用约4.5%的参数。这种稀疏激活的效率,使得Step 5 Preview模型能够在旗舰级智能水平下,将推理成本压到行业价格中位数以下。
这个技术选择的深层含义是:大模型Scaling的重心正在从“投入更多算力”转向“让每一份算力产生更多智能”。在这个过程中,架构设计、训练策略、工程优化的价值正在超越单纯的规模堆叠。Step 5 Preview模型的发布,可以看作这一趋势的一个标志性事件。
7.2 Agent能力将成为基座模型的分水岭
Step 5 Preview模型对Agentic任务的聚焦,反映了一个更深层的行业判断:能够自主执行多步骤复杂任务的模型,与只能进行单轮对话的模型,正在分化为两个不同的品类。
前者的技术挑战远不止是“更聪明”——它需要模型在数小时的任务执行中保持稳定的状态跟踪,需要模型在与真实硬件交互时正确处理异常和错误,需要模型在训练阶段就对齐推理时的行为模式。Step 5 Preview模型在ESP32开发板改造任务中连续执行超过3小时、在24小时GPU Kernel优化中自主迭代的能力,正是这些底层技术积累的外在表现。
对于开发者和企业用户来说,在选择基座模型时,Agent任务执行能力正在成为一个新的关键评估维度。
7.3 开源模型的“帕累托前沿”正在被重新定义
阶跃星辰用“帕累托前沿”来描述Step 5 Preview模型在智能与成本之间找到的最优边界。这个经济学概念的使用是精准的——在帕累托最优状态下,你无法在不牺牲一个维度的情况下改善另一个维度。
Step 5 Preview模型的发布正在推动这条前沿线向外扩展。它不是在“智能”和“成本”之间做了一个简单的取舍,而是通过架构创新和工程优化,让两者同时向前推进。这种进步对于整个AI应用生态来说,意味着更多的可能性正在打开——开发者可以在预算约束下使用更强的模型,企业可以将AI能力部署到更多的业务场景中。
当开源模型能够以更低的成本提供接近闭源旗舰的能力时,整个行业的创新节奏都会加快。Step 5 Preview模型的发布,正是这个加速过程中的一个重要节点。
八、常见问题解答(FAQ)
Q1:Step 5 Preview模型是什么?什么时候发布的?
Step 5 Preview模型是阶跃星辰于2026年9月20日发布的新一代旗舰基座模型,面向AI编程、软件工程、专业知识工作和金融等真实世界Agentic任务场景。
Q2:Step 5 Preview模型什么时候开源?
阶跃星辰将于2026年10月15日正式开源Step 5 Preview模型的完整权重。发布当日已全量开放API供开发者使用。
Q3:Step 5 Preview模型的参数规模是多少?
Step 5 Preview模型采用稀疏MoE架构,总参数量600B,每个Token激活参数仅27B,支持100万Token上下文窗口,原生支持文本与视觉输入。
Q4:Step 5 Preview模型的性能怎么样?
在Artificial Analysis Intelligence Index中,Step 5 Preview模型得分44分,位居全球开源模型前三,与参数量2.8万亿的Kimi K3持平,仅落后GLM-5.3与Claude Opus 5各一分。
Q5:Step 5 Preview模型的使用成本是多少?
Step 5 Preview模型的输入定价为每百万Token 1美元,输出定价为每百万Token 2.7美元,均显著低于行业价格中位数。单任务成本仅为Claude Opus 5的1/8,并支持95%的缓存折扣。
Q6:Step 5 Preview模型在编程方面表现如何?
在DeepSWE v1.1中得分67.7,在StepCodeBench中得分49.0,均领先同级别开源模型。模型能够处理Bug修复、功能开发、代码重构、环境配置等真实开发任务,并可在硬件编程场景中连续执行超过3小时。
Q7:Step 5 Preview模型和Claude Opus 5相比怎么样?
Step 5 Preview模型在ALE-CLI上以29.5分超越Claude Opus 5的28.6分,在FrontierFinance和DRACO上仅次于Claude Opus 5。两者在综合智能评分上仅差1分,但Step 5 Preview模型的使用成本更低,输出速度更快(99.8 vs 55.3 Token/秒)。
Q8:Step 5 Preview模型适合哪些应用场景?
Step 5 Preview模型重点面向AI编程、软件工程、专业知识工作、金融分析等需要长上下文、长程规划和持续工具调用的复杂Agent场景。
九、总结
Step 5 Preview模型是阶跃星辰在“智能效率”技术路线上的一次重要交付。它以600B总参数、27B激活参数的架构设计,实现了AA智能指数44分的综合表现,在开源模型阵营中跻身全球前三,同时在编程、金融、专业工作等领域展现出与国际顶尖模型竞争的实力。
对于开发者而言,Step 5 Preview模型提供了一个在能力、成本和效率之间取得良好平衡的选择;对于行业而言,它正在重新定义开源模型的“帕累托前沿”,让更强的智能以更低的成本触达更广泛的应用场景。
10月15日的开源,将是检验Step 5 Preview模型生态影响力的关键节点。届时,社区的反应和实际使用数据,将进一步回答一个核心问题:当旗舰级基座模型走向开源,整个AI应用创新的节奏会加快多少?