
蚂蚁开源万亿参数思考模型Ring-1T


2025年10月14日,蚂蚁集团正式发布并全面开源万亿参数思考模型Ring-1T,模型权重与训练配方同步公开,标志着全球首个开源万亿参数思考模型正式落地。该模型基于Ling 2.0 MoE架构,总参数达1万亿,每token激活约50B参数,数学推理能力达到IMO 2025银牌水平,综合能力逼近GPT-5。这不仅是参数规模的里程碑,更意味着万亿参数级深度推理能力首次走出封闭实验室,进入开放研究社区。
一、为什么万亿参数思考模型的开源值得认真对待
过去两年,大模型的“参数军备竞赛”从未停歇,但真正将万亿参数级别的思考模型完整开源这件事,直到2025年9月30日才第一次发生。那一天,蚂蚁百灵团队将Ring-1T-preview的权重上传到了Hugging Face,成为全球首个开源的万亿参数推理大模型。两周后的10月14日,正式版Ring-1T全面开源,同步公开了训练配方。
这个时间节点值得注意。2025年下半年,全球范围内具备万亿参数推理能力的模型——无论是OpenAI的GPT-5-Thinking系列,还是Anthropic的Claude系列——大多以闭源API的形式提供服务。Ring-1T选择了另一条路:把完整的模型权重、训练方法、强化学习系统一并开源。蚂蚁百灵大模型团队在技术报告中写道:“Ring-1T是我们在万亿思考模型上的首次尝试”,这句话背后透露的,是一个团队在极高技术门槛面前选择“公开解法”的自信。
一个更宏观的背景是:蚂蚁百灵大模型家族截至目前已发布18款模型,覆盖语言、思考、多模态三条产品线,参数规模从160亿延伸至1万亿,且全部开源。Ring-1T和此前发布的Ling-1T共同构成了百灵2.0阶段的两款万亿参数旗舰。这不是一次孤立的发布,而是一个系统性的开源战略的关键节点。
二、Ring-1T到底是什么:从参数表到能力画像
2.1 核心参数一览
理解Ring-1T,需要先看几个关键数字。Ring-1T采用Ling 2.0 MoE(混合专家)架构,总参数量为1万亿(1000B),每次推理激活约50B参数,上下文窗口支持128K tokens。这组数据说明了一个核心设计思路:用万亿参数的“知识容量”去支撑深度推理,同时用稀疏激活来控制每次推理的算力开销。
1/32的专家激活比是Ling 2.0架构的重要特征。这意味着模型虽然拥有庞大的参数储备,但每次处理一个token时只调用约3%的参数参与计算。这与GPT-5的MoE策略类似——据报道,GPT-5采用约1.8万亿参数的MoE架构,动态路由机制仅激活约1/5的参数参与推理。两者都选择了“大而稀疏”的技术路线,但Ring-1T的激活比例更低,理论上在推理效率上更有优势。
2.2 架构层面的关键选择
Ring-1T的技术底座来自Ling-1T-base,后者是在超过20万亿token语料上完成预训练的万亿参数基座模型。在此基础上,百灵团队进行了三个阶段的后训练:LongCoT-SFT(长思维链监督微调)、RLVR(可验证奖励强化学习)和RLHF(人类反馈强化学习)。
这个后训练策略的巧妙之处在于分工明确:SFT阶段教会模型“如何展开一段长推理”,RLVR阶段用可自动验证的奖励信号(如数学题的正确答案)来强化推理的准确性,RLHF阶段则负责让模型的输出更符合人类偏好——不只是“答对”,还要“说得好”。Ring-1T在Arena-Hard V2人类偏好对齐测试中以81.59的成功率位居开源模型榜首,逼近GPT-5-Thinking(High)的82.91,正是RLHF阶段的效果体现。
2.3 从Ling-1T到Ring-1T:同一基座,两种能力取向
理解Ring-1T的定位,需要将其与同门的Ling-1T做区分。两者共享Ling 2.0架构和Ling-1T-base基座,但后训练的目标截然不同。Ling-1T定位为通用语言大模型,强调指令遵循、代码生成和创意写作等即时响应能力;Ring-1T则专注于“思考”——即在给出最终答案之前,先进行一段深度推理过程,类似于人类解题时先打草稿、再写正式答案。
这种“同基座、双分支”的策略,实际上是一种高效的资源利用方式:一次万亿参数级别的预训练投入,可以支撑两种不同能力取向的模型产品。从工程角度看,这降低了万亿参数模型的研发边际成本;从开源社区的角度看,研究者可以基于同一个基座,探索“快思考”和“慢思考”两条不同的对齐路径。
三、技术深潜:让万亿参数模型“不崩”的工程方法
万亿参数思考模型的训练,最大的技术挑战不是“让模型变聪明”,而是“让它不要崩”。这里涉及一个行业公认的难题:训推精度差异。
简单来说,训练阶段和推理阶段因为实现细节的不同(如数值精度、并行策略、算子实现等),会产生微妙的分布偏移。在参数量较小的模型中,这种偏移可以被容忍;但当模型规模攀升到万亿参数、训练序列达到数万token、强化学习迭代上千步时,这种偏移会像复利一样指数级放大,最终导致训练崩溃。
3.1 IcePop算法:把漂移“冻结”在低水位
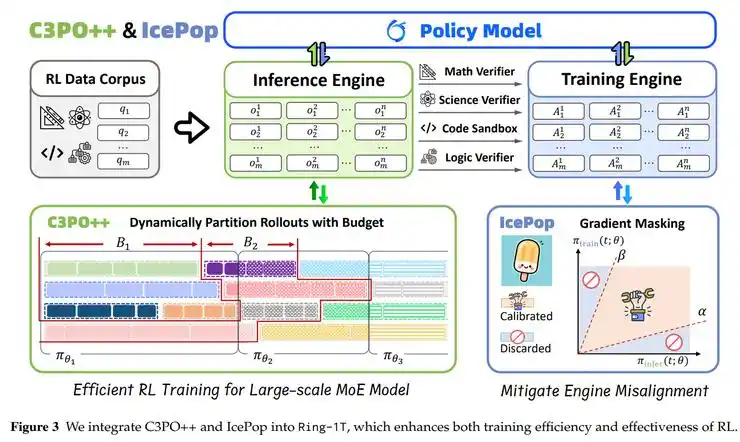
蚂蚁百灵团队为此自研了“棒冰”(IcePop)算法。其核心思路是用带掩码的双向截断技术,把训练-推理分布差异“冻结”在一个低水位,确保长序列、长周期训练不崩。
从公开的对比数据来看,IcePop的效果是显著的:在训练过程中,传统GRPO方法的训推差异随着训练步数呈指数上升,而IcePop能够将这种差异维持在一个相对平稳的低水平。这意味着万亿参数模型的强化学习训练,第一次可以被“稳定跑成日常”。
3.2 ASystem:万亿参数强化学习的“基础设施”
如果说IcePop解决的是“稳定性”问题,那么ASystem解决的是“可行性”问题。万亿参数模型的强化学习训练,涉及的显存管理和权重交换复杂度远超常规模型。ASystem针对这些痛点做了精细优化,实现了单机显存碎片秒级回收、权重零冗余交换。
这套系统的意义在于:它降低了万亿参数模型进行强化学习训练的工程门槛。ASystem中已开源的AReaL框架,让其他研究团队也有机会在类似的规模上尝试强化学习训练。
四、性能表现:用数据说话
4.1 横向对比
以下表格将Ring-1T与同代代表性模型在关键维度上进行对比:
| 对比维度 | Ring-1T | Ling-1T | GPT-5-Thinking(High) | Kimi K2 Thinking |
|---|---|---|---|---|
| 总参数量 | 1万亿 | 1万亿 | 约1.8万亿(MoE) | 1万亿 |
| 激活参数 | 约50B | 约50B | 约1/5参数动态激活 | 未公开 |
| 架构 | Ling 2.0 MoE | Ling 2.0 MoE | MoE+动态路由 | MoE+INT4量化 |
| 上下文窗口 | 128K | 128K | 400K | 未明确 |
| AIME 25 | 92.6(预览版) | — | 94.6(无工具) | 接近GPT-5水平 |
| CodeForces | 94.69 | — | 低于94.69 | 超过/接近GPT-5 |
| Arena-Hard V2 | 81.59 | — | 82.91 | — |
| 开源状态 | 全面开源 | 全面开源 | 闭源 | 开源 |
Ring-1T预览版在AIME 25测试中取得92.6分,超越所有已知开源模型及Gemini 2.5 Pro,接近GPT-5(无工具使用)的94.6分;在CodeForces测试中斩获94.69分,超过GPT-5。正式版的通用能力进一步提升,Arena-Hard V2的81.59分和HealthBench的开源领域最佳成绩,表明它在“答得对”和“答得好”两个维度上都达到了开源模型的顶尖水平。
4.2 IMO 2025:一次“极限压力测试”
最值得深入讨论的性能指标,是Ring-1T在IMO 2025赛题上的表现。百灵团队将Ring-1T接入多智能体框架AWorld,使用纯自然语言推理进行解题,没有借助任何代码执行工具。
结果是:Ring-1T仅用一次就解出了第1、3、4、5题,相当于IMO银牌水平,成为首个能拿IMO国际奥数奖的开源系统。在第2题几何证明中,经过三次尝试给出了接近满分的证明过程;在最难的第六题中,答案收敛到“4048”,虽然与正确答案2112仍有距离,但已经与Gemini 2.5 Pro处于同一水平。
这个成绩的意义需要放在更宽的语境中理解:IMO级别的数学证明要求的不只是计算能力,更是严格的逻辑推导、多步规划和对数学语言的精准运用。Ring-1T在纯自然语言推理条件下达到这个水平,说明它的“思考链”不是简单的模式匹配,而是在一定程度上具备了结构化的推理能力。
五、落地维度:Ring-1T能做什么
5.1 有据可查的应用场景
从目前已公开的信息来看,Ring-1T在实际场景中的表现覆盖了多个专业领域。在法律文书分析场景中,有开发者尝试将其用于融资合同的风险识别,反馈是“0.8秒输出了32个风险点,连隐蔽的隐藏担保条款都精准识别”,准确率比之前使用的通用模型高出15%。更有意义的是部署门槛:经过FP8量化优化后,单张3090显卡即可流畅部署,这意味着万亿参数模型不再需要专属的数据中心环境。
在医疗研究场景中,Ring-1T被用于汇总数千篇罕见病研究论文,在数小时内生成基于证据的文献综述。在供应链分析场景中,它可以对全球供应链数据和地缘政治事件进行多步因果推理,为制造企业提供风险缓解策略建议。这些场景的共同特征是:需要处理大量信息、进行多步推理、给出结构化的分析结论——恰好是思考模型的核心能力区间。
5.2 演进式思维链与效率平衡
一个容易被忽视但非常重要的技术细节是:Ring-1T(以及后续的Ling-1T)采用了演进式思维链(Evo-CoT)技术,在保障思考正确率的同时显著降低token资源消耗。蚂蚁方面将这一优化描述为实现“任务效果与计算成本之间的帕累托最优”。
这背后反映了一个务实的产品思维:思考模型如果每次推理都生成冗长的思维链,即使能力再强,在真实场景中的可用性也会大打折扣。Evo-CoT的目标是让模型学会“该想多少就想多少”——简单问题快速给出答案,复杂问题才展开深度推理。这种自适应机制,是思考模型从“实验室演示”走向“生产可用”的关键一步。
六、行业视角:开源思考模型的能力边界与竞争格局
6.1 一个被低估的信号
Ring-1T的开源,在技术社区引发的讨论热度远不及同期的闭源模型发布。但从行业结构的角度看,这件事的意义可能被低估了。
2025年下半年,万亿参数思考模型的竞争集中在少数几家闭源实验室之间。Kimi K2 Thinking在11月发布后登顶开源模型榜首,训练成本约460万美元,被视为“又一个DeepSeek时刻”。阿里的Qwen3-Max-Thinking同样以超万亿参数和19项基准测试的SOTA成绩加入竞争。Ring-1T在10月的开源,比这两次发布都更早,而且它在开源程度上走得更远——不仅开源权重,还开源了训练配方和强化学习系统的核心组件。
这个选择背后的逻辑值得琢磨:一个万亿参数思考模型的训练成本、工程复杂度和人才密度都是极高的,开源意味着把巨大的研发投入转化为公共品。蚂蚁在2025年的研发投入达到350.3亿元,连续四年研发投入占营收比例超过10%。Ring-1T的开源可以看作这种投入策略的一部分——通过开放底层能力来吸引社区共建,而不是通过封闭API来获取短期回报。
6.2 开源思考模型的“能力天花板”在哪里
一个诚实的讨论需要承认:Ring-1T在IMO第六题上的表现——答案收敛到4048而非2112——暴露了当前思考模型的真实边界。即使是最强的开源系统,在面对需要深度数学直觉和创造性构造的题目时,仍然存在明显的不足。Gemini 2.5 Pro在同一题上给出了相同的错误答案,说明这不是Ring-1T独有的问题,而是当前技术范式的共性局限。
这个边界的存在,恰恰是开源价值最大的地方。闭源模型的失败案例通常不可见——用户只能看到精心挑选的演示。而开源模型允许研究社区系统性地分析失败模式,理解模型在什么类型的推理上会出错、为什么会出错。Ring-1T在IMO第六题上的“4048”不仅是一个错误答案,更是一个研究线索。
6.3 从Ring-1T到Ring-2.6:一条可见的演进路径
从Ring-1T到2026年6月发布的Ring-2.6-1T,可以清晰地看到百灵团队的迭代方向。Ring-2.6-1T将激活参数从50B提升到63B,上下文窗口从128K扩展到256K,内存访问开销降低10倍,吞吐量提升3倍。更关键的转变是定位:Ring-2.6-1T明确面向“真实Agent工作流”,支持可调节的推理强度(high/xhigh),在工具密集型、多轮Agent场景中实现更强的性能与更低的token开销之间的平衡。
这条演进路径透露出的信息是:思考模型的技术竞争正在从“基准测试分数”转向“真实工作流中的可靠性和效率”。Ring-1T作为第一代开源万亿思考模型,主要证明了“能行”;Ring-2.6则开始回答“好用不好用”的问题。对于关注这一领域的研究者和开发者来说,理解这条演进逻辑,比记住具体的基准分数更有价值。
七、FAQ常见问题
Q1:Ring-1T和Ling-1T有什么区别?
两者共享Ling 2.0架构和万亿参数基座,但后训练目标不同。Ling-1T定位为通用语言大模型,强调即时响应、代码生成和指令遵循;Ring-1T定位为思考模型,在给出最终答案前会进行深度推理过程,擅长数学证明、复杂逻辑分析和多步规划。
Q2:Ring-1T可以免费使用吗?
模型权重以MIT协议在Hugging Face和魔搭社区开源,可自由下载使用。用户也可以通过蚂蚁百宝箱等平台在线体验。API服务方面,SiliconFlow等平台提供按量付费的调用方案。
Q3:运行Ring-1T需要什么样的硬件配置?
经过FP8量化优化后,单张RTX 3090显卡即可部署推理,但完整的万亿参数模型权重约2TB,首次加载需要较大的存储空间。对于生产级部署,建议使用多卡配置以获得更好的吞吐量。
Q4:Ring-1T的数学能力到底有多强?
在IMO 2025赛题的自测中,Ring-1T使用纯自然语言推理达到银牌水平,一次解出第1、3、4、5题,第2题几何证明接近满分,第六题答案与Gemini 2.5 Pro相同但未命中正确答案。在AIME 25测试中取得92.6分,接近GPT-5(无工具)的94.6分。
Q5:IcePop算法解决的是什么问题?
解决的是万亿参数MoE模型在长周期强化学习训练中的“训推精度差异”问题。简单说,训练和推理阶段的数值差异会随着训练步数指数级放大,最终导致训练崩溃。IcePop通过带掩码的双向截断技术将这种差异“冻结”在低水位,确保训练稳定。
Q6:Ring-1T适合哪些实际应用场景?
目前有公开案例的场景包括:法律合同风险分析(识别隐藏条款)、医疗文献综述(汇总罕见病研究)、供应链因果分析(地缘政治风险评估)、数学竞赛解题、代码调试与生成等。核心适用场景是那些需要“多步推理+结构化输出”的专业任务。
Q7:Ring-1T和GPT-5的差距有多大?
在数学推理(AIME 25)上差距约2分,在代码生成(CodeForces)上Ring-1T预览版反而超过GPT-5,在人类偏好对齐(Arena-Hard V2)上差距约1.3个百分点。整体上,Ring-1T在多个维度已经非常接近GPT-5,但在超长上下文和某些需要创造性直觉的任务上仍有差距。
八、结语:开源的真正变量
Ring-1T的开源,在技术层面的直接贡献是提供了一个万亿参数思考模型的完整参考实现——包括权重、训练配方和强化学习系统。但在更深的层面上,它提出的问题比它给出的答案更有价值。
当万亿参数级别的深度推理能力不再是少数实验室的专属资源,研究社区可以用它来做什么?法律文书分析、医疗文献综述、供应链风险评估——这些已经出现的应用场景,都还处于非常早期的探索阶段。真正的变化可能发生在那些目前还无法预见的场景中:当一个偏远地区的数学教师可以用Ring-1T来设计竞赛题目,当一个独立研究者可以用它来验证一个数学猜想,当一个初创团队可以用它在48小时内搭建一个需要深度推理的专业分析工具。
蚂蚁在2025年的研发投入是350.3亿元,Ring-1T是这些投入的产出之一。选择开源,意味着把这些投入转化为公共基础设施。这个选择在短期内的回报可能不如闭源API直接,但它对技术生态的影响更为深远。Ring-1T在IMO第六题上的那次“4048”,或许比它的银牌成绩更能说明问题:开源的价值不在于展示完美,而在于让更多人看到边界在哪里,然后一起去推。