
2026年11月最新AI视频制作实操:从脚本到成片,新手也能学会的短视频流程(保姆级教程)

大多数人开始制作AI视频时就走错了方向。他们打开视频模型,写下一大段提示词,生成了10个片段,然后纳闷,为什么角色、光影、场景和故事一直在变?
“大多数AI视频,在生成开始之前就已经失败了。”
问题不在模型,在于把写提示词,当成了AI视频制作的全部。真正的AI视频制作更接近导演工作,故事、摄影、表演指导、美术设计、连贯性、剪辑、声音,缺任何一层,画面就会散。
这篇文章我们就把从脚本到成片的完整流程拆开,每一步给框架、给模板、给示例,看完你就能跑通自己的第一条AI短视频。
AI视频示例
为什么失败
先看一条典型的失败提示词:
“电影质感,一名男子在城市中奔跑。写实风格,4K。”
这段话描述了一种氛围,但没有对具体镜头下达任何指令。观众该注意什么?画面里有谁?他在做什么?摄像机在哪?光从哪来?动作引发了什么物理反应?镜头从哪开始、到哪结束?一个都没回答。
模型只能猜,猜出来的东西,十个片段十个样。一个专业的AI视频提示词,必须回答这些问题:
观众应该注意到什么?
画面中有谁?
他们具体在做什么?
摄像机位于何处?
使用的是什么镜头?
演员如何表演?
光源来自哪里?
动作引发了哪些物理反应?
镜头从何处开始,又在何处结束?
正确的工作流
在打开视频模型之前,先把这十步走一遍:
✅️ 写出故事核心构思(一句话)
✅️ 将其拆解为5到8个镜头
✅️ 先创建角色、场景和道具的参考素材
✅️ 确定画面朝向、服装、光影和空间布局
✅️ 针对每个镜头分别编写提示词
✅️ 明确每个镜头的起始帧和结束状态
✅️ 在现有基础上进行微调,而非推倒重来
✅️ 在增加更多镜头前,先进行剪辑以把控节奏
✅️ 最后加入对白、环境音、音效和音乐
✅️ 在进入下一场戏之前,检查并确保连贯性
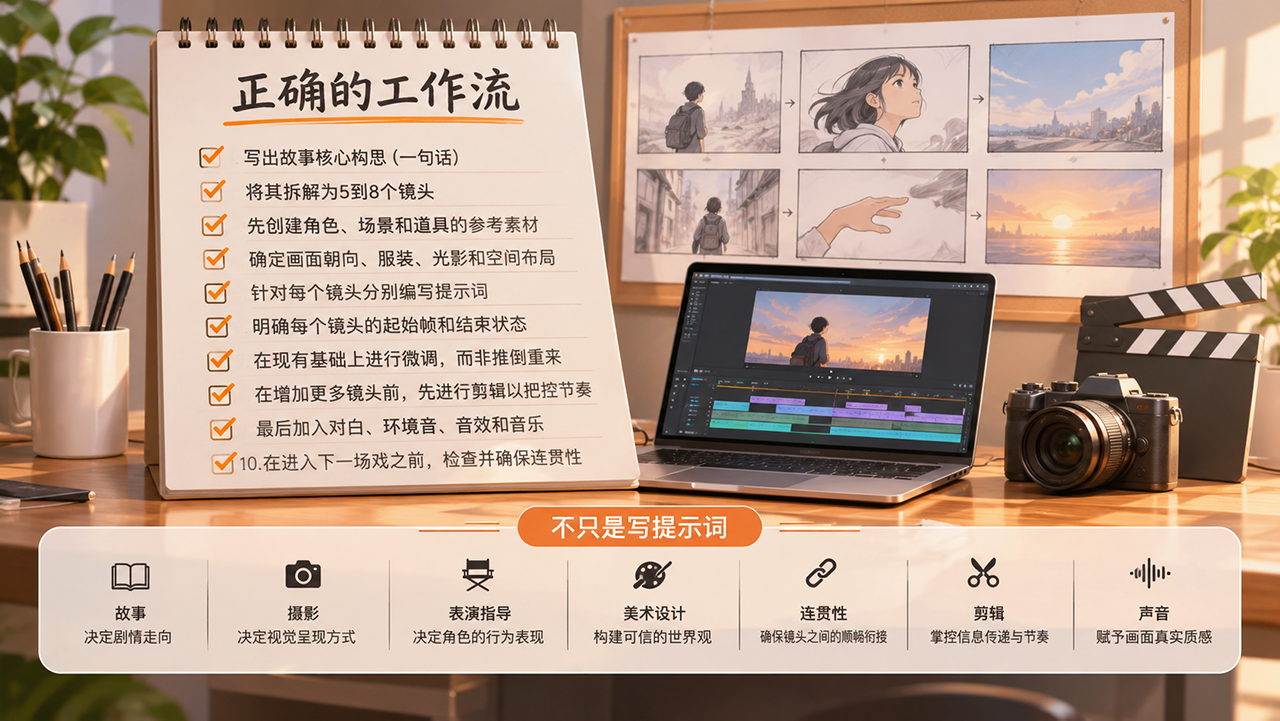
AI视频制作不仅仅等同于写提示词,提示词只是其中一个层面。你还需要:
- 故事:决定剧情走向
- 摄影:决定视觉呈现方式
- 表演指导:决定角色的行为表现
- 美术设计:构建可信的世界观
- 连贯性:确保镜头之间的顺畅衔接
- 剪辑:掌控信息传递与节奏
- 声音:赋予画面真实质感
提示词框架
我所采用的框架是:
意图 → 主体+动作 → 构图 → 光学 → 摄像机 → 表演+物理反应 → 光影+空间 → 连贯性
1. 意图
在动笔之前,先明确这个镜头的作用是什么。是为了揭示信息?营造紧张感?展现规模?还是捕捉某种反应?如果镜头本身没有目的,任何镜头语言都无法挽救它。
2. 主体+动作
不要写男人很害怕,而要写出具体的行为:“他僵在门口,双眼循声望去,肩膀紧绷,随后缓缓向后退去。”提示词应聚焦于可见的行为。
3. 构图
明确摄像机所捕捉的内容。远景=地理环境与规模;中景=动作与人物关系;特写=情绪与反应;插入镜头=关键细节。在此基础上,仅在必要时添加角度、高度和构图方式。
4. 光学
镜头的选择会改变画面呈现。24mm=环境、透视感、速度感;35mm=自然的空间张力;50mm=平衡的、符合人眼的视角;85mm=压缩感与亲密感;微距=触感丰富的细节。不要仅仅因为“听起来很有电影感”就加上“35mm”之类的参数,要清楚你为什么要用它。
5. 摄像机
设定一种有明确动机的摄像机运动方式。固定、推入、拉出、跟随、手持拍摄、平移、俯仰、摇臂、环绕。摄像机的运动应服务于叙事,为故事增色。
6. 表演与物理规律
这是许多AI生成镜头表现不佳的地方。具体指令应包含:视线、呼吸、迟疑、姿态、重心转移、脚部着地、动量(惯性)、服装的动态反应、与物体的交互、平衡与恢复。“跑得很快”过于笼统;“加速奔跑,打滑半步,稳住重心后继续前行”,这样的描述能为模型提供物理层面的信息。
7. 光影与空间
描述具有逻辑依据的光影。不要写“电影感光效”,而应写“来自画面右侧温暖的钠灯光,冷色调的雨天环境光,以及湿润沥青路面上强烈的反光”。仅描述那些对画面有实际影响的环境细节。
8. 连贯性
每个镜头都处于两种状态之间。明确以下要素:起始位置、画面朝向、服装、道具、比例尺度、地理环境、结束位置。在生成多个片段时,这一点尤为重要。
完整示例(Seedance 2.5)
下面是一条经过实战验证的完整提示词,可以改名字和场景复用。
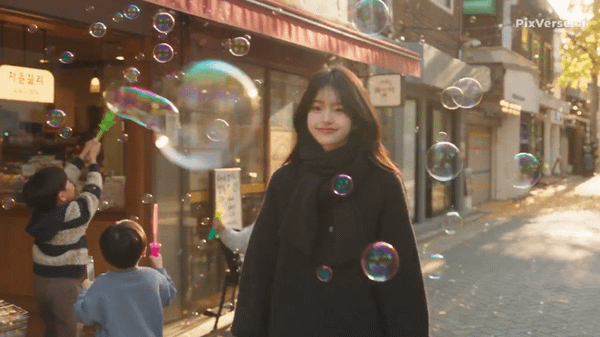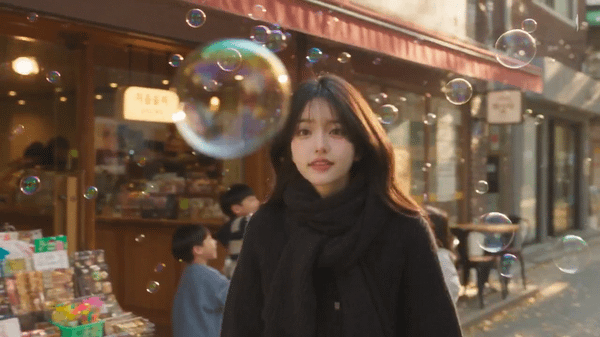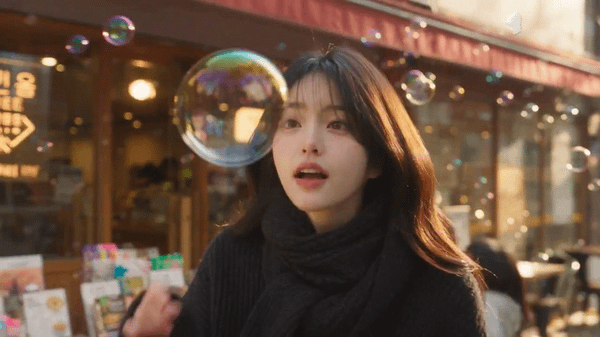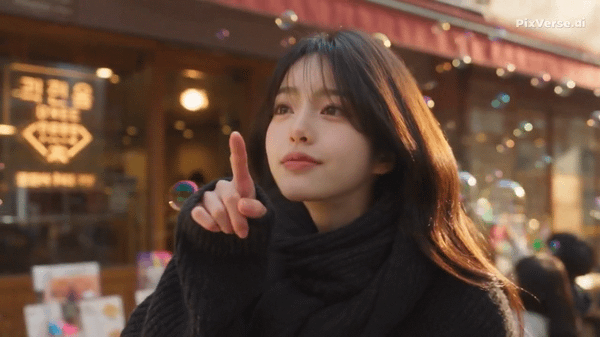
提示词:
制作一段30秒、超写实、16:9横屏视频。视频主角是一位24岁的韩国女性,她天生丽质,留着一头自然披散的深色长发,妆容清淡自然;身穿宽松的黑色针织毛衣和休闲长裤,颈间围着一条柔软的针织围巾。在整段视频中,必须保持其面部特征、发型、着装、围巾款式及身材比例的一致性。
场景设定在首尔一个宁静而迷人的居民区,时间是秋日午后。街边的小店、狭窄的人行道、温馨的咖啡馆、街头摊贩、散落的金黄色落叶,以及温暖的阳光,共同营造出一种充满怀旧气息的日常生活氛围。
时间轴(四个镜头):
镜头1,0–7秒:
气球的惊喜 她漫步在居民区的人行道上,享受着午后时光。不远处,一位街头摊贩正拿着一束五彩缤纷的氦气球。突然,几个气球脱手飘向空中,其中一个气球向她飘来。她注意到了,伸手抓住了气球的绳子,脸上流露出惊喜而真诚的笑容。镜头以一种略带晃动的手持视角,自然地跟随她移动。
镜头2,7–14秒:
泡泡的世界 她继续前行,看到几个孩子正在一家小店外玩巨大的肥皂泡。几十个透明的泡泡在温暖的午后阳光下飘荡,折射出绚丽的彩虹光泽。一个大泡泡飘到她面前,她轻轻伸出手指将其戳破,发出自然的笑声。捕捉她脸上那一抹细微而愉悦的神情。
镜头3,14–21秒:
友好的小狗 她沿着人行道继续向前走,一只毛茸茸的奶油色小狗兴奋地摇着尾巴向她跑来。她停下脚步,蹲下身子,轻轻抚摸小狗的头。小狗欢快地摇着尾巴,甚至还短暂地抬起前爪向她示意。她轻声笑着,亲昵地拍了拍小狗,随后起身继续前行。
镜头4,21–30秒:
秋日的尾声 她继续在首尔一条绿树成荫的街道上漫步。一阵秋风拂过,金黄色和橙色的落叶在她周围翩翩起舞。她放慢脚步,抬头望向飘落的树叶,俏皮地张开双臂。几片落叶从镜头前飘过。她转过身,对着镜头露出温暖而真诚的微笑,随后继续沿着洒满阳光的街道前行,镜头则在她身后静静跟随。
为什么这么写?
意图清晰:每个镜头都有一个明确的叙事节点(惊喜→愉悦→温暖→收束)
主体+动作具体:不是她很开心,而是伸手抓住气球的绳子,脸上流露出惊喜而真诚的笑容
表演有物理细节:轻轻伸出手指将其戳破;蹲下身子,轻轻抚摸小狗的头
连贯性锁死:开头就写明了必须保持面部特征、发型、着装、围巾款式及身材比例的一致性
每个镜头只做一件事:没有在7秒里塞五个动作
seedance2.5 vs wan3.0
八层框架,几乎适用所有主流视频模型。但不同模型对提示词的口味不一样,措辞的侧重有时需要改一下。
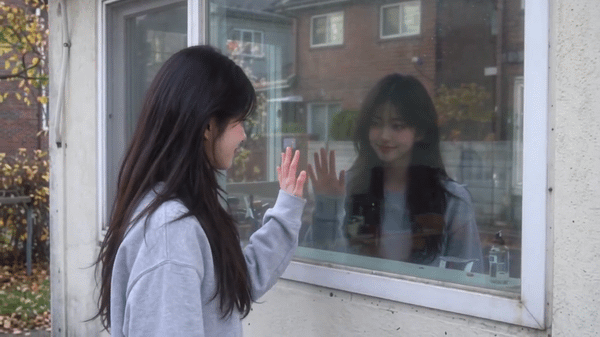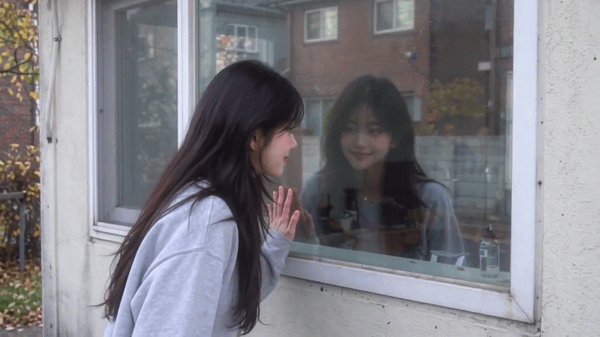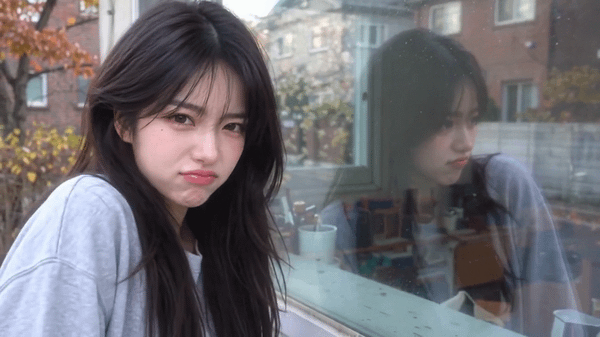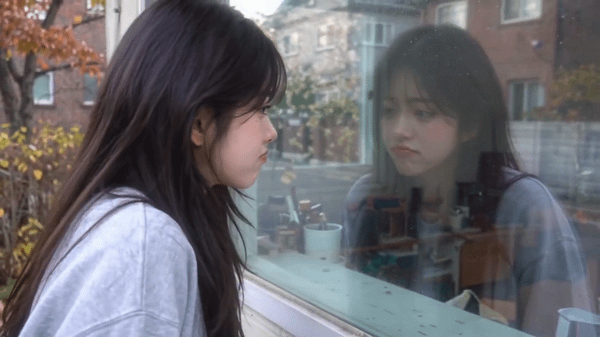
Wan 3.0 提示词:
制作一段15秒、超写实、16:9横屏视频。视频主角是一位24岁的韩国女性,长相自然迷人,留着一头随意的深色长发,妆容清淡;她身穿一件宽松的酒红色连帽卫衣,搭配宽松的休闲裤,并围着一条柔软的针织围巾。在所有镜头中,必须保持其面部特征、发型、服装、围巾及身材比例完全一致。
镜头1,0–3秒:
在秋日凉爽的午后,一条安静的居民区街道上,她从一栋带有大玻璃窗的小房子旁走过。她随意地瞥向窗户,突然发现了自己的倒影。她放慢脚步,微微歪头,对着倒影露出了一个充满好奇的浅笑。镜头从她后侧方跟随拍摄。
镜头2,3–6秒:
她停在窗前,抬起一只手。倒影也几乎在同一瞬间抬起了手。她觉得很有趣,便轻轻左右晃动头部,带着愈发浓厚的好奇心观察着倒影的动作。
镜头3,6–9秒:
她俏皮地“测试”了一下倒影——耸起一侧肩膀,做了个鬼脸,还短暂地鼓起了腮帮子。倒影完美地复刻了她的每一个动作。她忍住笑意,随后凑近玻璃,仔细端详着自己的倒影。
镜头4,9–12秒:
她将手掌轻轻贴在玻璃上,倒影的手掌也从另一侧贴了上来。她保持这个姿势片刻,脸上带着温柔的微笑。一辆过往车辆的车灯短暂地扫过玻璃,光影与她的倒影以及室内隐约可见的景象交织在一起。
镜头5,12–15秒:
她收回手,对着倒影轻轻挥了挥,仿佛在道别,随后继续向前走去。走出两步后,她回头望向窗户,最后露出了一个充满笑意的神情,接着便沿着人行道走远了。
视觉风格:呈现出21世纪初索尼MiniDV(磁带摄像机)拍摄的家庭录像质感;画面由他人拍摄,而非自拍视角。画面带有轻微的手持抖动、不完美的构图、随性的镜头调整、偶尔出现的自动对焦寻焦过程、细微的曝光变化、柔和的对比度以及略显淡雅的色彩;呈现出真实的皮肤质感,并伴有秋日下午自然的光影。玻璃上的倒影应显得真实可信,同时又能隐约透视窗外的景象。整体氛围应保持亲密、自然且富有魅力,而非刻意追求电影质感。
动态表现:动作流畅、连贯且实时呈现,包含自然的行走、头部倾斜、手势动作及面部表情。倒影必须精准同步人物的动作,确保时机吻合且身体比例一致。人物及其倒影的面部特征、发型、着装和整体外观必须保持高度统一。严禁出现倒影动作脱节、镜像延迟、面部扭曲、人物重影、画面卡顿、抖动、丢帧或慢动作现象。
音频:仅包含自然的户外环境音,轻柔的脚步声、微风声、远处的车流声以及衣物摩擦的细微声响。不应包含背景音乐、旁白或人工合成的音效
Seedance 2.5是简单的4个镜头,重点在漫步的氛围感。Wan 3.0这条是5个镜头节奏更碎、更紧凑,因为需要多个小动作来推进,抬手、歪头、耸肩、贴掌、挥手,每一个都是一次情绪递进,镜头密度跟着叙事需求走。
这里增加了更多锁定词,防止生成意外。严禁出现倒影动作脱节、镜像延迟、面部扭曲、人物重影,因为倒影题材对同步性要求极高,一个延迟就全毁了。怎么写锁定次,取决于题材的风险点在哪。
怎么选、怎么写:
做氛围向、情绪向的片子,镜头可以长一点,Seedance 2.5的7秒一镜很舒服
做动作互动、细节推进的片子,镜头要碎一点,3秒一镜更灵活
题材本身有高风险物理关系(倒影、水花、布料、多人物交互),把严禁出现什么,写成独立段落
风格如果靠不完美成立,把不完美拆成具体的技术特征写,如21世纪初索尼MiniDV拍摄的家庭录像质感、轻微手持抖动
框架是通用的,措辞是对应模型的。八层想清楚了,换成哪个模型都不慌,变的只是怎么把想清楚的东西翻译成那个模型听得懂的话。
新手建议
在制作你的第一部AI短片时,务必设定严格的限制:
1个角色,1个场景,1个明确的目标,5到8个镜头,10到20秒的时长。
如果能让这段内容保持连贯、意图明确且情感清晰,再考虑扩大规模。不要试图在8秒的生成片段中塞入五个动作、三种运镜方式以及两次情绪转变。 一个镜头,一套机位,一个明确的叙事节点。
避坑指南
坑1:只写氛围,不写镜头
症状:生成结果随机,十个片段十个样
解决方案:用八层框架逐项检查,每个镜头都要回答“观众该注意什么”
坑2:一个镜头塞太多动作
症状:动作混乱、变形、穿模
解决方案:一个镜头只做一件事,复杂动作拆成多个镜头
坑3:忽略表演的物理细节
症状:人物动作僵硬、像在飘
解决方案:写清楚视线、呼吸、重心转移、服装动态
坑4:图生视频还在重复描述参考图
症状:提示词冗长,生成效果反而下降
解决方案:参考图已经定义了外貌,提示词只写动态
坑5:先做风格化再剪节奏
症状:在节奏不对的片段上反复调风格,浪费生成次数
解决方案:先剪好表演和节奏,再做风格化处理
工具清单
环节 | 推荐工具 | 特点 |
脚本/分镜 | DeepSeek、Claude、ChatGPT | 免费额度充足 |
角色/场景参考图 | GPT Image、即梦 | 一致性控制强 |
视频生成 | Seedance 2.5、可灵3.0 | 图生视频稳定,支持多模态参考 |
剪辑/调色/字幕 | 剪映 | 免费版够用 |
声音 | Seedance内置、剪映AI | 口型同步,环境音生成 |
写在最后
AI视频制作不是写提示词,是当导演。
故事决定剧情走向,摄影决定视觉呈现,表演指导决定角色行为,美术设计构建可信的世界观,连贯性确保镜头衔接,剪辑掌控节奏,声音赋予真实质感。
把上面那套八层框架复制过去,先用1个角色、1个场景、5-8个镜头、10-20秒跑一遍。跑通了,再扩大规模。
大多数AI视频在生成开始之前就已经失败了,但如果你在生成之前就把该想清楚的都想清楚了,它就不会失败。
塔猴是一个专业的AI接单平台,汇聚海量真实商单。所有商单均经人工审核认证,真实有效。入驻零门槛,零保证金,交易通过三方监管账户托管,专业运营团队全流程参与交付,阶段验收达标后结款。
同时,塔猴也为想提升技能的用户提供AIGC实战课程与前沿资讯,让你在学习和实战中成长。
